小米大模型,为什么还敢押注罗福莉?
罗福莉周围一直有两种完全相反的声音。
一种是,“AI 天才少女”、“DeepSeek 出走者”、“小米大模型负责人”。
另外一种是,“只会营销”、“30岁还叫少女”、“骗子”。
但现实却是,小米没有回应争议,而是默默地把更大的筹码压在了她身上。
近期,小米的内部晋升通知显示,罗福莉在加入小米10个月后升至22级,成为小米最年轻的高管。而此前负责红米业务的王腾,花费8年时间,也不过21级。
图源:Znews 公开报道
01 她为什么被骂只会营销?
围绕罗福莉,最容易被讨论的是她的人设。
北京大学毕业,女性,阿里达摩院未来星项目,DeepSeek v2核心负责人。这些标签放在一起,很容易包装成一个无脑的爽文故事。
另外一面,她在张小珺商业访谈录中的表现,却打破了人们的幻想:说话结结巴巴、想到哪里说到哪,对open claw不留余力的吹捧。一度被网友说成骗子。
人们总是喜欢这样,把所有的优点、灯光聚集到一个人身上,把她捧上神坛,成为圣人。又不断用挑剔的眼光寻找一丝瑕疵。一旦出现问题,好像就大逆不道。
罗福莉在自己社交媒体简介这样写道:做难而正确的事情,请不要再神话和消费个人。她并不赞同这种天才叙事,把所有的努力付出归因于与生俱来的天赋。
真实的她甚至反对“天才少女”的标签。就像她在北大访谈中说的:“我不是天才,我的起点很普通,是对本质问题探索的好奇心、不错的行动力以及一点点不服输的韧劲,才一步步走到今天。”
02 小米押注的不是“天才少女”
小米看中的,从来不是所谓天才的标签,而是她从学术界走向产业界,并在达摩院、DeepSeek积累的失败经验、工程意识。
她出生在四川宜宾,从小也并不是尖子生,后来进入北京师范大学,50人的班上她是最普通的那个,排名30位左右。别人三分钟能做出的编码题,她得花三小时。
为了保研到北大,她大三提前联系导师,进入北大语言计算实验实习。进入时,她连最基础的Python语言也不会,快速入门Python,并发表顶会论文。
毕业之后,她没有继续自己的学术生涯,而是进入产业界。进入了阿里达摩院,传说中录取率1%不到的阿里星项目,在这里她主导开发了多语言模型VECO,服务电商业务的垂直模型。
也在这里她遭遇了职业生涯的第一次滑铁卢。他们设想模型参数越高,大模型的智能水平也就越高。挑战GPT-3,尝试超大规模语言模型,训练1750亿参数的模型。从实验室的几张卡,到成千上万张卡的集群。结果并没有迎来预期中的智能水平大幅提升,反而得到一个又大又笨拙的模型。
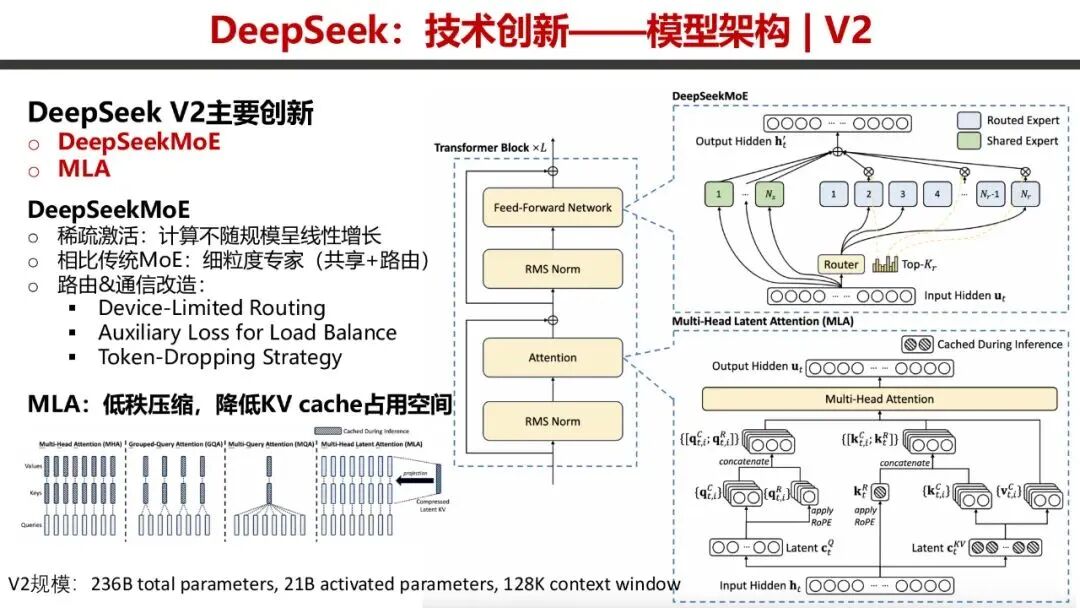
后来,她离开了阿里,来到了彼时还寂寂无名的幻方量化(DeepSeek)。她把阿里大模型训练失败的经验带来了。在这里她主导开发了DeepSeek v2,把推理成本降低到每百万仅1元人民币。
图源:CSDN 公开资料整理
正是这些经历,让她积累了模型搭建能力和低成本推理的经验。这也正是小米最需要的两项能力。小米需要的从来不是全球最强通用大模型,而是便宜、好用,能够塞进人-车-家生态的大语言模型。
03 200 人团队,能做什么?
在访谈中,罗福莉透露小米团队的初期规模大概是100人左右,后面陆续拓展到200人。团队成员多来自清华、北大。但是其中,很多都是新人、实习生。
图源:东方财富网公开报道
把这个团队规模放到国际范围来看,它并不大。
OpenAI人员规模是4500人,现金消耗大概是170亿美元左右;Anthropic的团队规模大概在2500人左右,融资650亿美元。
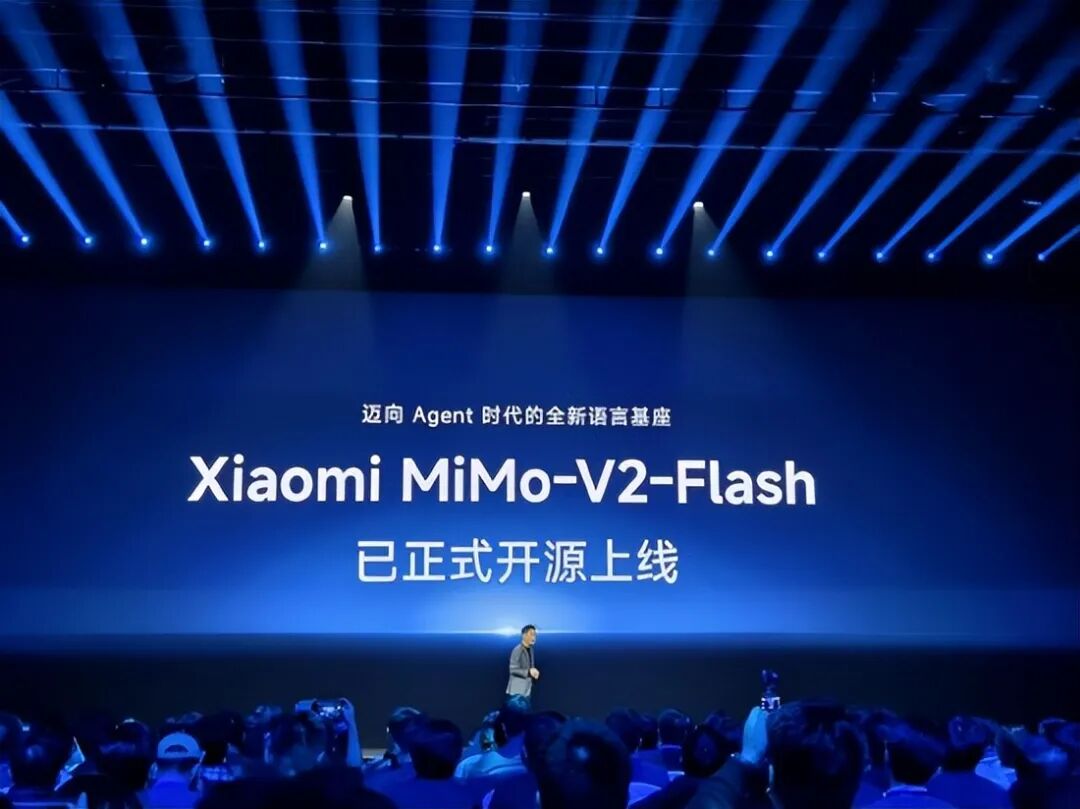
而从官方直播展示的信息来看,MiMo的小时训练成本是3万美元,累计训练成本是百万美元。团队规模也不过数百人。
算力、人才密度和资金投入的限制决定小米AI模型不在第一梯队。这似乎是资源限制,而不是能力问题。小米不是美国企业,没办法复刻财大气粗的玩法,挖顶尖人才,疯狂堆算力,巨额投入,只能错位竞争,疯狂拼透明度,疯狂拼后训练。
这也是为什么非罗福莉不可的原因,在DeepSeek v2版本她已经证明了自己。
04 最好的回答,不是人设,而是成绩
回答争议最好的办法,往往不是解释,而是让结果自己说话。
具体到AI领域,就是模型的性能、成本和落地会回应这一切。
9月发布的全新一代的MiMo-V2.6,杀穿开源榜单,以46分,拿下开源模型第一的位置。
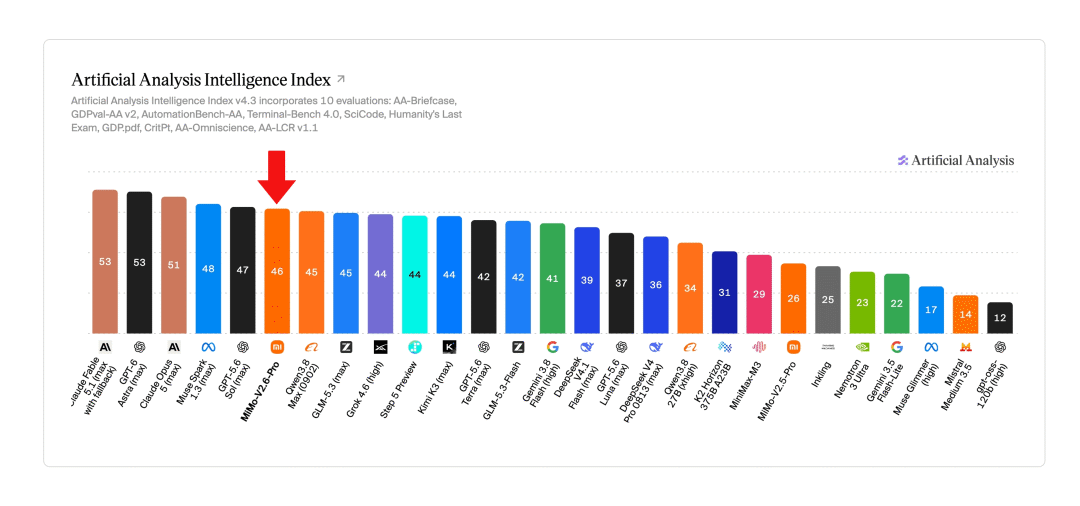
图源:Xiaomi MiMo 官方文档 / Artificial Analysis Intelligence Index
输入价格为每百万 token 0.025 元,缓存未命中为每百万 token 3 元,输出价格为每百万 token 6 元。对比DeepSeek 0.15、4.5、13.5的费用,还要便宜30%以上。
更关键的是mimo模型还具备多模态能力。除了文字处理外,例如,调用 Blender 处理建模任务,辅助 coding 完成网站开发,处理真实办公数据等。这意味着我们可以用MiMo-V2.6来写代码,做PPT,建模和智能体协作。
如果你问小米模型是不是最好用的模型,我想大概率不是。
但它代表的是一种更现实的路径:用更低成本,解决足够复杂、足够具体的任务。